
En samlet pipeline med tekst og tabulære features
MachineLearningMastery beskriver, hvordan man bygger en unified scikit-learn-pipeline, der kombinerer tekst-embeddings fra en letvægts open-source sprogmodel med øvrige tabulære features. Fokus i gennemgangen er praktisk anvendelse med konkrete trin til at få embeddings ind i scikit-learn-økosystemet uden at ændre de gængse arbejdsmønstre (kilde 3200).
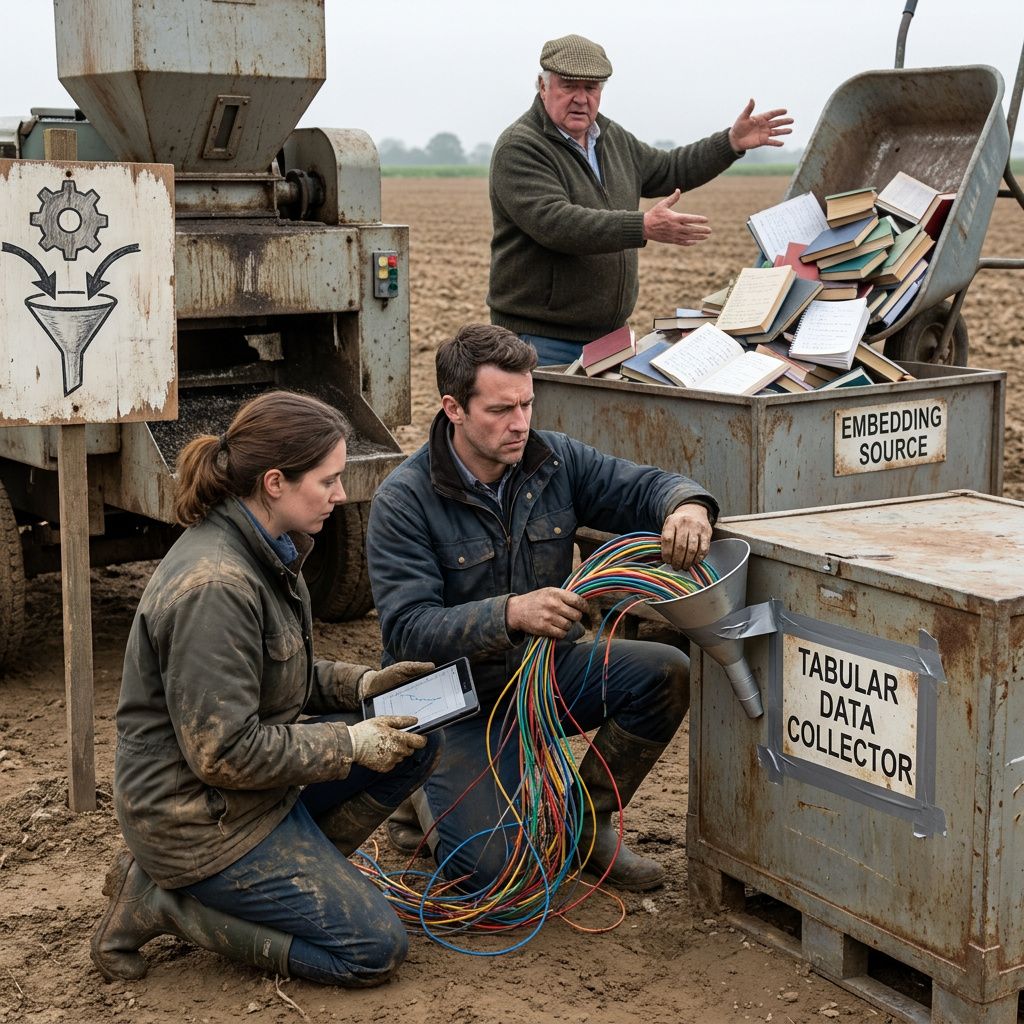
Kernen er, at tekst omdannes til vektorer via en sprogmodel, og at disse vektorer kan stilles på linje med numeriske og kategoriske felter i samme pipeline. Ifølge guiden er opskriften baseret på velkendte scikit-learn-komponenter, så integrationen passer ind i eksisterende workflows (kilde 3200).
Hvad guiden konkret dækker
Guiden angiver, at embeddings produceres af en letvægts open-source sprogmodel. Den nævner ikke et konkret modelnavn eller licens, så modelvalget er åbent. Pointen i materialet er, at tekstvektorer kan indgå i samme feature-rum som andre kolonner og trænes og anvendes sammen med dem (kilde 3200).
Den praktiske tilgang beskrives som en trinvis brug af scikit-learn-komponenter: en transformer til tekst, som leverer embeddings, en mekanisme til at samle kolonner, og en estimator, der arbejder på den samlede matrix. Arbejdsformen følger scikit-learn-logikken med fit og transform, så eksisterende mønstre og tests kan genbruges (kilde 3200).
Teknisk opbygning i scikit-learn
Ifølge MachineLearningMastery pakkes embedding-modellen ind i en scikit-learn-kompatibel transformer. Dermed kan tekstkolonner passere et tydeligt trin, der returnerer tætte vektorer i et format, som downstream-komponenter kan bruge. Resten af opsætningen kan holdes til standardelementer fra scikit-learn, så kæden fremstår ensartet (kilde 3200).

Guiden lægger op til at kombinere flere typer features i én pipeline, så en estimator kan trænes på en samlet repræsentation. Den beskriver et workflow med fit og transform i samme stil som andre scikit-learn-projekter, hvilket holder udvikling og anvendelse inden for kendte rammer (kilde 3200).
Arkitektur og driftsperspektiv
Et manual brief peger på, at arkitekturen vinder på genbrugelige pipelines, et separat embedding-lag og kompatibilitet med scikit-learn. Briefet fremhæver også styrings- og driftsaspekter som relevante hensyn ved produktionel brug, men går ikke i detaljer med specifikke værktøjer eller målinger (kilde 3201).
Set samlet tegner kilderne en ramme, hvor semantik fra tekst bliver en del af tabulær modellering uden at skifte til andre rammer. Idéen er at holde pipeline-komponenter adskilte og genbrugelige, så de kan styres og versioneres på samme måde som øvrige trin (kilder 3200, 3201).
Deployment med SageMaker SDK v3
AWS beskriver, at SageMaker SDK v3 leverer et redesign, som skal gøre bring-your-own-model-workflows mere strømlinede. Ifølge AWS erstatter v3 rammespecifikke estimator-klasser med en samlet ModelTrainer til træning og ModelBuilder til deployment. Desuden kan SDK’en synkronisere en lokal kildekode-mappe ind i træningsjobbet ved brug af den nye SourceCode-konfiguration (kilde 3202).
AWS skriver også, at man kan vælge et image fra Amazon Elastic Container Registry, herunder AWS Deep Learning Containers eller et selvbygget image. Kombinationen af BYOM og SourceCode-synkronisering giver ifølge AWS en mere fleksibel arbejdsgang for træning og inferens, hvilket kan være relevant, når en embedding-komponent skal indgå sammen med øvrige pipeline-trin (kilde 3202).
Modelvalg og begrænsninger i kildematerialet
MachineLearningMastery nævner en letvægts open-source sprogmodel, men ikke modelnavn, version eller licens. Det efterlader model- og licensvalg åbent for læseren. Kilden leverer en metode og en pipeline-struktur, ikke en modelanbefaling (kilde 3200).

Manual briefet fremhæver arkitektur- og governance-hensyn omkring pipelines og embedding-lag, men uden en fuld playbook. Budskabet er at holde styr på arkitektur og styring; de praktiske detaljer om målinger, retræning og datahåndtering beskrives ikke i briefet (kilde 3201).
Hvad kilderne ikke dækker
Kilderne fremlægger ikke benchmarks for latency, throughput, memory-forbrug eller effekter ved at kombinere embeddings med tabulære features. Læseren får en integrationsopskrift, men må selv foretage målinger i egen kontekst (kilde 3200).
Der gives ikke et navngivet modelvalg eller licens, ingen detaljer om vektorlagring eller konkrete databaser til det formål, og heller ikke en komplet CI/CD- eller MLOps-playbook. Arkitektur- og governance-vinklen er omtalt på overordnet niveau (kilder 3200, 3201).
Hvorfor det alligevel er brugbart
Selv uden tal er der praktisk værdi i, at løsningen holder sig inden for scikit-learn. Det mindsker integrationsarbejdet, fordi kode, mønstre og tests ofte allerede findes. Det er præcis den ramme, MachineLearningMastery opstiller: en vej til at få semantiske signaler fra tekst ind i tabulære modeller uden at skifte platform (kilde 3200).
AWS’ gennemgang af SageMaker SDK v3 supplerer billedet for teams, der vil køre træning og deployment i en managed skyopsætning. AWS angiver eksplicit, hvordan BYOM kan udføres mere strømlinet, og hvordan kildekode kan synkroniseres ind i jobkørsler, så iterationer kan forenkles (kilde 3202).
Næste skridt inden produktion
Hvis pipeline-mønstret fra MachineLearningMastery følges, vil et nærliggende næste skridt være at vælge en konkret open-source model og afklare licensvilkår. Derudover bør teams etablere egne målinger for kvalitet og performance, da kilderne ikke leverer benchmarks (kilde 3200).
For teams med AWS-setup kan det være relevant at afprøve BYOM med SDK v3 i et afgrænset miljø, så kildekode-synkronisering, container-image og deployment-kæden er på plads, før en løsning skaleres. Det er forhold, AWS beskriver i sin gennemgang af v3 (kilde 3202).
Bundlinjen
Maskinlæring på tabulære data kan udvides med semantiske signaler fra tekst inden for rammerne af scikit-learn. MachineLearningMastery giver opskriften. Et manual brief sætter arkitektur- og governance-linjer. AWS viser, hvordan BYOM-workflows i SageMaker SDK v3 kan støtte træning, deployment og iteration. Det, som ikke er dækket i kilderne, må afklares i den konkrete implementering, før man går i produktion (kilder 3200, 3201, 3202).
